
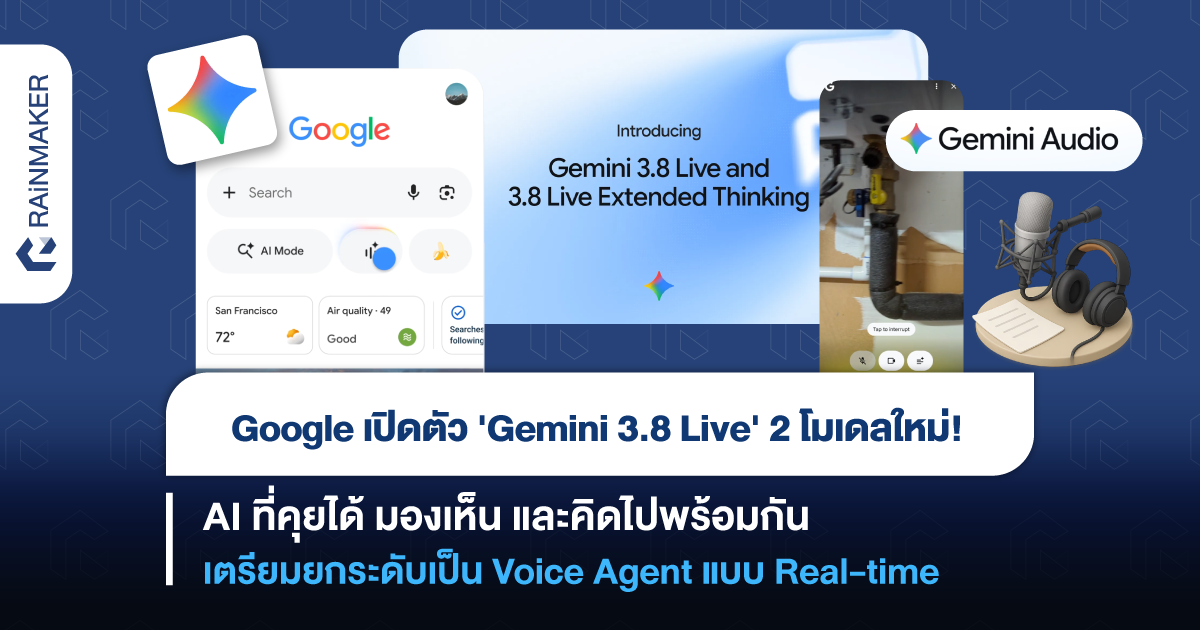
เมื่อวันที่ 16 กันยายนที่ผ่านมา Google ได้เปิดตัว ‘Gemini 3.8 Live’ และ ‘Gemini 3.8 Live Extended Thinking’ โมเดล AI สำหรับการสนทนาแบบ Live รุ่นใหม่ที่มีความก้าวหน้าที่สุดของ Google ในตอนนี้ โดยการอัปเดตครั้งนี้ได้เน้นการยกระดับ Intelligence การให้เหตุผลแบบขนาน และการโต้ตอบด้วยเสียงแบบใกล้เรียลไทม์
โดยเป้าหมายสำคัญคือทำให้การพูดคุยกับ AI มีความเป็นธรรมชาติมากขึ้น ขณะเดียวกันก็สามารถจัดการงานที่ซับซ้อนผ่านเสียงได้ โดยไม่จำเป็นต้องหยุดการสนทนาเพื่อรอให้ AI ประมวลผลเสร็จ
Gemini 3.8 Live & Gemini 3.8 Live Extended Thinking
ซึ่ง Gemini 3.8 Live นั้นได้ถูกพัฒนาสำหรับการใช้งานในวงกว้าง โดยจะเน้นไปที่ความสมดุลระหว่างความสามารถในการสนทนา ความลื่นไหล และต้นทุน ที่พร้อมรองรับการทำความเข้าใจบริบทจากภาพแบบใกล้เรียลไทม์
ส่วน Gemini 3.8 Live Extended Thinking นั้นถูกออกแบบมาสำหรับงานที่มีความซับซ้อนสูงขึ้น โดยเพิ่มความสามารถด้าน Intelligence และ Multi-step Reasoning เข้ามาเพื่อทำให้ AI สามารถคิดเป็นหลายขั้นตอนและจัดการ Workflow ที่ซับซ้อนได้ ขณะที่ยังคงพูดคุยกับผู้ใช้ต่อเนื่องไปด้วย
Gemini 3.8 Live
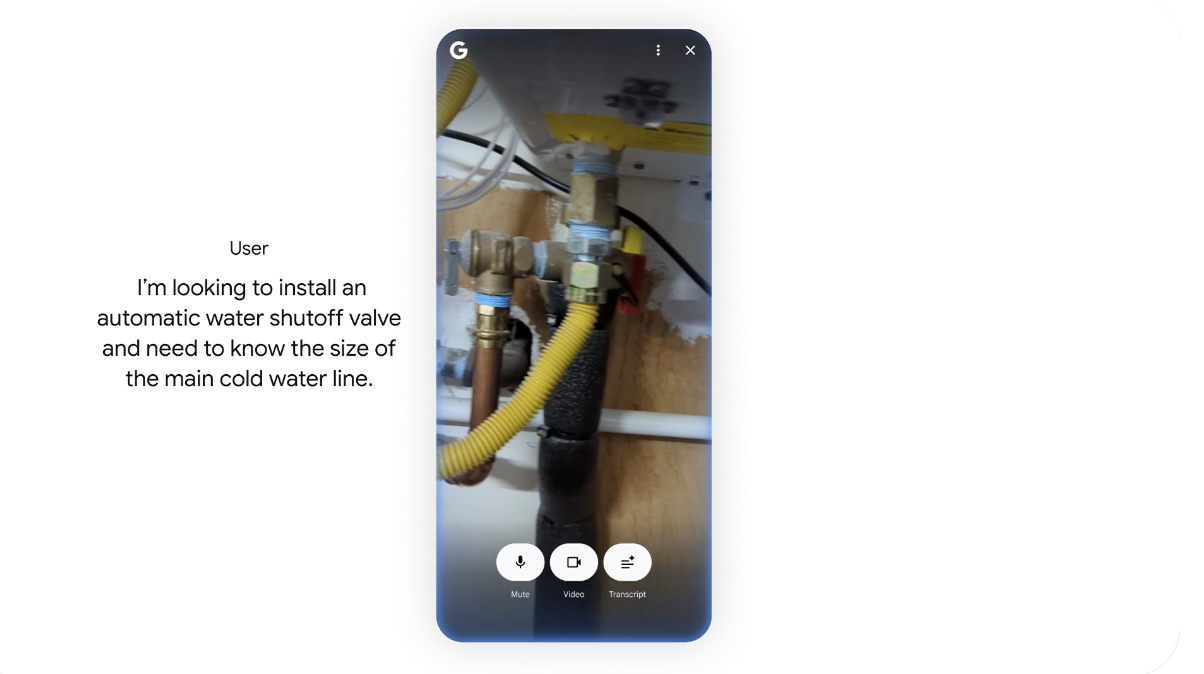
จุดเด่นของ Gemini 3.8 Live คือความสามารถในการประมวลผล Visual Input แบบใกล้เรียลไทม์มากขึ้น ทำให้ AI จะสามารถนำสิ่งที่ผู้ใช้กำลังมองเห็นมาเป็นบริบทประกอบการสนทนาได้ทันที
ทั้งนี้ Google ได้กล่าวว่าโมเดลนี้จะรองรับได้ถึง 97 ภาษาและสามารถตรวจจับและเปลี่ยนภาษาระหว่างการสนทนาได้โดยอัตโนมัติ ทำให้การสนทนาแบบหลายภาษาเป็นไปอย่างต่อเนื่องมากขึ้น อีกทั้งความสามารถที่สำคัญคือการเรียกใช้ Tools และ API เบื้องหลัง ขณะที่ยังคงพูดคุยกับผู้ใช้ได้อยู่ได้
ตัวอย่างเช่นหากผู้ใช้งานสั่งการ AI ทำงานที่ต้องใช้เวลา Gemini จะสามารถรับคำสั่ง แจ้งให้ผู้ใช้ทราบว่ากำลังดำเนินการ และไปจัดการงานนั้นเบื้องหลังโดยที่บทสนทนาไม่จำเป็นต้องหยุดลง หรือการใช้ Gemini 3.8 Live ในการ Onboarding พนักงาน โดย AI สามารถใช้ข้อมูลจากภาพที่เกิดขึ้นตรงหน้าเพื่อช่วยตอบคำถามแบบสด ๆ นั่นเอง
Gemini 3.8 Live Extended Thinking
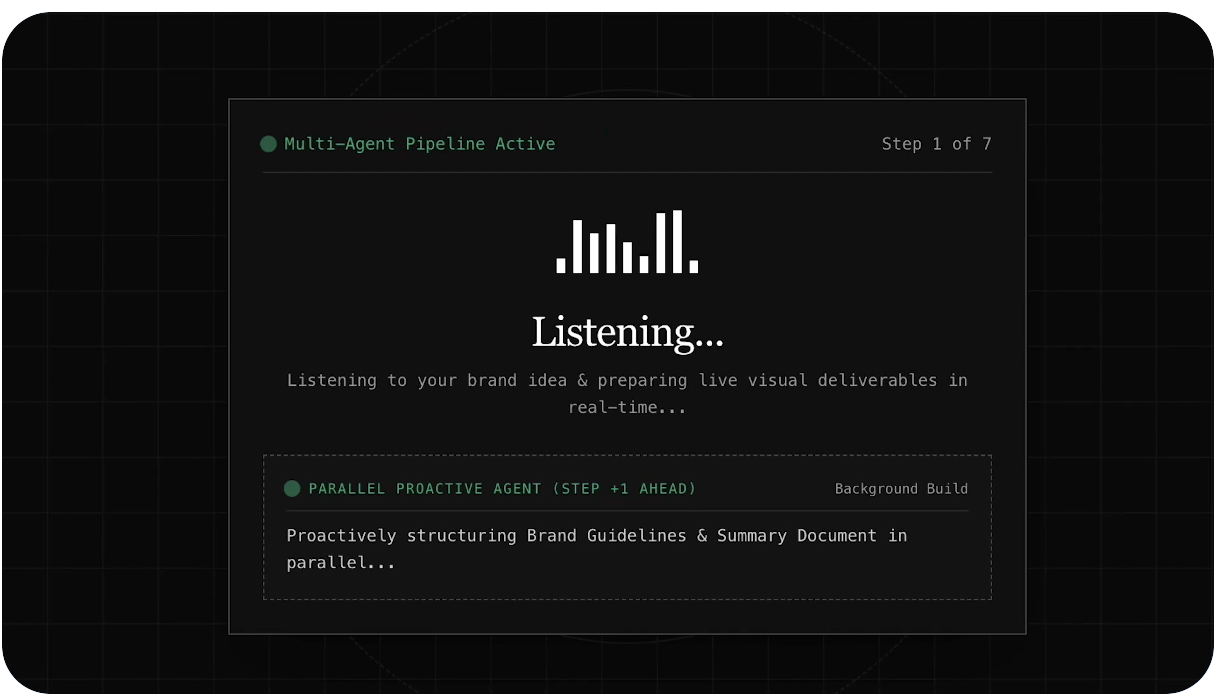
สำหรับงานที่ต้องใช้การคิดวิเคราะห์หลายขั้นตอน Google เพิ่มความสามารถ Extended Thinking เข้ามา โดยความแตกต่างสำคัญคือ AI ไม่จำเป็นต้องเงียบเพื่อคิดจนเสร็จก่อนจึงตอบผู้ใช้ แต่สามารถ Reason และ Speak ไปพร้อมกันได้
อย่างเช่น AI อาจพูดว่า “Let me check that…” เพื่อส่งสัญญาณว่ากำลังตรวจสอบข้อมูล จากนั้นสามารถอัปเดตความคืบหน้าระหว่างที่กำลังทำงานเบื้องหลังได้ แนวทางนี้เองที่ทำให้ AI สามารถจัดการงานที่มีหลายขั้นตอนโดยที่ผู้ใช้ยังสามารถพูดคุยและโต้ตอบกับ AI ได้ตลอดกระบวนการ เช่น
- เปลี่ยน ภาพสเก็ตช์ให้กลายเป็น React Components พร้อมให้ Feedback ด้วยเสียงแบบใกล้เรียลไทม์
- จัดการ การจองหลายขั้นตอน พร้อมเรียกใช้ฟังก์ชันแบบ Asynchronous
- สร้าง Business Plan และ Marketing Toolkit ผ่านการพูดคุยด้วยภาษาธรรมชาติ
- ทำงานร่วมกับ Google Workspace ผ่าน Docs, Gmail และ Keep
เน้นทั้งความฉลาดและความเป็นธรรมชาติ
นอกจากนั้นการเปิดตัวครั้งนี้ Google ยังได้นำผลการทดสอบจากหลาย Benchmark มาแสดงในหน้าเปิดตัว โดยเฉพาะประสิทธิภาพด้าน Voice Agent
โดย Gemini 3.8 Live Extended Thinking ได้คะแนนไปถึง 82.6 และขึ้นเป็นอันดับ 1 โดยรวมบน Artificial Analysis Speech to Speech Quality Index
ส่วนด้าน Agentic Task Completion โมเดลทำได้ 68.6% บน τ-Voice และ 35.1% บน Sierra τ-Voice Banking Benchmark ส่วนความสามารถด้าน Reasoning จาก Big Bench Audio ได้คะแนน 97.7%
ขณะที่ Gemini 3.8 Live ได้อันดับ 2 ใน Speech Agent Arena โดย Google เน้นจุดเด่นเรื่องความคุ้มค่าและความสามารถในการรองรับการใช้งานในระดับ Scale
ภาพกราฟ Benchmark
มีการเปรียบเทียบประสิทธิภาพของโมเดลในหลายด้าน ได้แก่
- Speech-to-Speech Quality
แสดงประสิทธิภาพด้านคุณภาพของการสนทนาแบบเสียงต่อเสียง - Agentic Performance
เปรียบเทียบความสามารถในการทำงานแบบ Agent ที่ต้องจัดการภารกิจให้สำเร็จ - Sierra τ-Voice Banking
วัดความสามารถของ AI ใน Workflow ด้าน Banking ที่ต้องใช้การสนทนาและการดำเนินงานหลายขั้นตอน - Cost per Hour of Input Audio
แสดงต้นทุนเมื่อเทียบกับโมเดลอื่น ๆ โดย Google ใช้ประเด็นนี้เพื่อชูว่า Gemini 3.8 Live ยังคงเน้นความคุ้มค่าสำหรับการนำไปใช้งานจริงในวงกว้าง
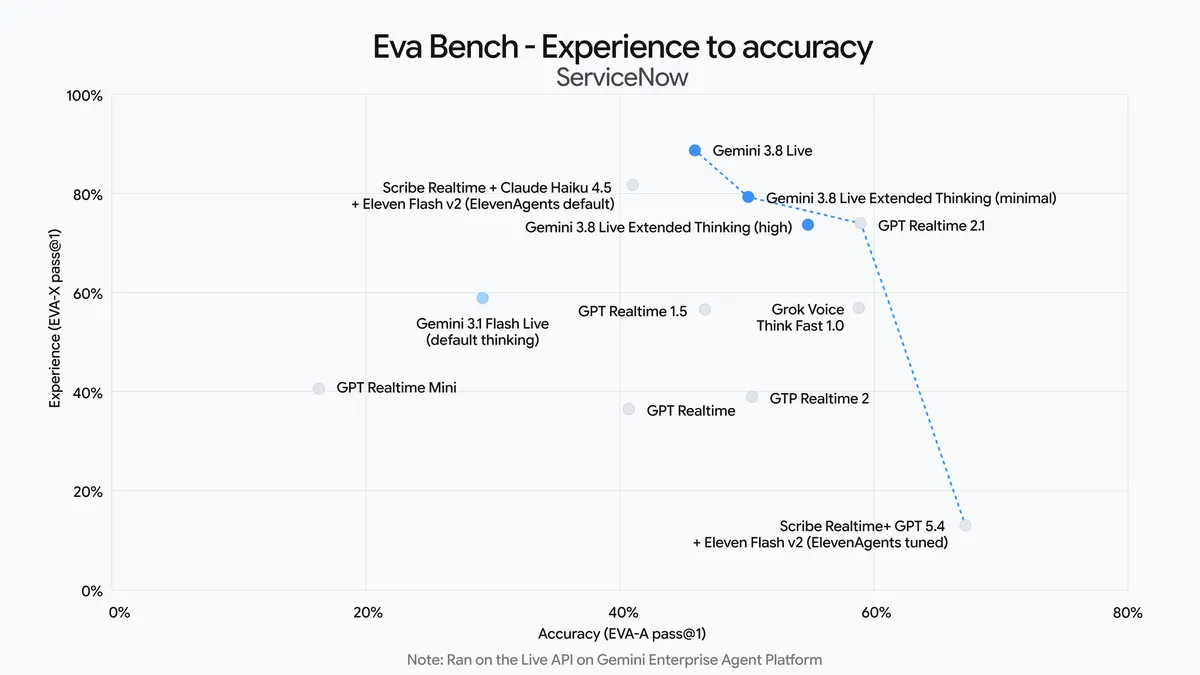
นอกจากนี้ Google ยังระบุว่าโมเดลของตัวเองสามารถสร้างสมดุลระหว่าง Accuracy และ Conversational Quality ใน ServiceNow EVA-Bench ซึ่งเป็น Benchmark สำหรับประเมิน Voice Agent ในงาน Workflow ที่มีความซับซ้อน
จาก Voice Assistant สู่ Voice Agent
ทำให้เห็นได้ว่าตอนนี้ Google กำลังวาง Gemini 3.8 Live ให้เป็นพื้นฐานสำหรับการสร้าง Voice Agent ที่นำไปใช้งานจริงได้ผ่าน Gemini Live API ซึ่งนักพัฒนาสามารถนำโมเดลไปสร้างระบบ Voice-driven Interface ของตัวเอง
โดยมีแพลตฟอร์มอย่าง Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel และ Vision Agents เข้ามาช่วยจัดการระบบ Media Streaming แบบ Real-time ที่อยู่เบื้องหลังทำให้นักพัฒนาสามารถโฟกัสกับการออกแบบ User Experience มากขึ้น แทนที่จะต้องสร้างระบบ Streaming ทั้งหมดด้วยตัวเอง
โดยกำลังร่วมมือกับบริษัทอย่าง Salesforce, Genspark และ Lumeris ซึ่งกำลังนำ Gemini 3.8 Live และ Gemini 3.8 Live Extended Thinking ไปใช้งาน โดยให้ความสนใจเป็นพิเศษกับ Latency, ความลื่นไหลของบทสนทนา และความสามารถในการเรียกใช้ Tools
Google Workspace
อย่างไรก็ตามความสามารถของ Live Models ไม่ได้จำกัดอยู่แค่ API สำหรับนักพัฒนา แต่ Google กำลังนำไปใช้กับผลิตภัณฑ์ของตัวเองด้วย สำหรับ Google Workspace ผู้ใช้สามารถทดลองใช้ Gemini 3.8 Live Extended Thinking ผ่าน
- Docs Live
- Gmail Live
- Keep Live
ขณะที่ Search Live สามารถใช้ Gemini 3.8 Live เพื่อช่วยแก้ปัญหาแบบ Step-by-step ผ่านการสนทนาแบบ Real-time ได้
SynthID
อีกประเด็นที่ Google เน้นคือเรื่องการระบุเสียงที่สร้างโดย AI โดยเสียงทั้งหมดที่สร้างโดยผลิตภัณฑ์ AI ของ Google จะถูกฝัง SynthID Watermark ซึ่งเป็นลายน้ำที่มองไม่เห็นและถูกฝังเข้าไปใน Audio Output โดยตรง
จากเป้าหมายที่ต้องการทำให้เสียงที่สร้างโดย AI สามารถตรวจจับได้ เพื่อช่วยลดความเสี่ยงจากการนำเสียง AI ไปใช้สร้างข้อมูลที่ทำให้เกิดความเข้าใจผิดในอนาคตมากขึ้นนั่นเอง
สุดท้ายนี้ Gemini 3.8 Live ได้เริ่มเปิดให้ใช้งานตั้งแต่วันที่ 15 กันยายน 2026 ได้แก่
สำหรับ Developer
- Gemini API
- Google AI Studio
สำหรับ Enterprise
- Private Preview ใน Gemini Enterprise
- เตรียมเปิดให้ใช้งานใน Gemini Enterprise for Customer Experience
สำหรับผู้ใช้ทั่วไป
- Search Live
ส่วน Gemini 3.8 Live Extended Thinking เปิดให้ใช้งานผ่าน
สำหรับ Developer
- Gemini API
- Google AI Studio
สำหรับ Enterprise
- Private Preview ใน Gemini Enterprise
- เตรียมเปิดให้ใช้กับ Gemini Enterprise for Customer Experience
- เตรียมเปิดให้ลูกค้า Google Workspace Business
สำหรับผู้ใช้ทั่วไป
- Gemini Live
- Google AI Pro และ Ultra ใช้งานใน Workspace ผ่าน Docs
- ผู้สมัครสมาชิก Google AI ทุกระดับสามารถใช้งานผ่าน Gmail และ Keep ได้
สิ่งที่น่าจับตาจากการเปิดตัวครั้งนี้ไม่ใช่แค่การที่ Gemini พูดเก่งขึ้นแต่คือการขยับจาก Voice AI ที่รอรับคำสั่ง Voice Agent ที่สามารถรับฟัง มองบริบท คิดหลายขั้นตอน เรียกใช้ Tools และทำงานเบื้องหลังไปพร้อมกับการสนทนา
สำหรับครีเอเตอร์เองความสามารถด้านของ Visual Context, Real-time Voice และ Extended Thinking สามารถต่อยอดไปสู่การทำงานที่ใช้เสียงและภาพร่วมกัน ไม่ว่าจะเป็นการให้ AI ช่วยดูงานระหว่างทำคอนเทนต์ ให้ Feedback กับงานออกแบบแบบสด ๆ หรือช่วยเปลี่ยนไอเดียที่พูดออกมาให้กลายเป็นชิ้นงานจริง
ขณะที่แบรนด์เองก็สามารถการเปิดใช้งาน Gemini Live API ไปสร้าง Voice Agent ของตัวเอง ซึ่งอาจทำให้ประสบการณ์ Customer Service, Sales และการทำงานภายในองค์กรเปลี่ยนจากระบบถาม-ตอบ ไปสู่ AI ที่สามารถสนทนาและดำเนินงานต่อให้ได้ในบทสนทนาเดียวนั่นเอง